चार मुख्य मोड
हर मोड अक्षरों की सीमा के बदले सघनता देता है। न्यूमेरिक मोड सिर्फ़ अंक सँभालता है, पर तीन अंक 10 बिट में पैक कर देता है, जबकि बाइट मोड कोई भी बाइट सँभालता है पर हर एक पर 8 बिट खर्च करता है।
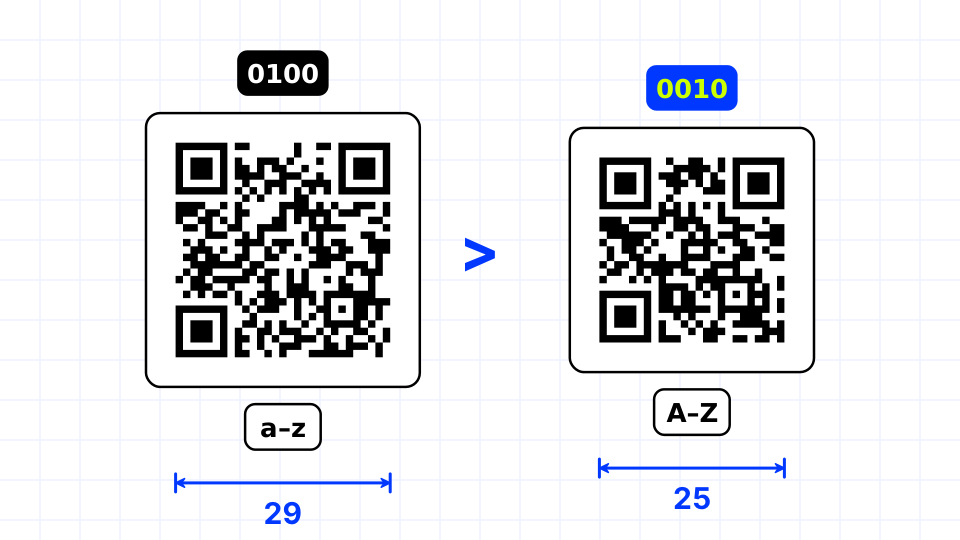
अल्फ़ान्यूमेरिक मोड 45 अक्षरों का एक सेट कवर करता है: अंक 0–9, अंग्रेज़ी के बड़े अक्षर A–Z, स्पेस, और चिह्न $ % * + - . / तथा कोलन। छोटे अक्षर इस सेट में नहीं हैं, इसीलिए पूरी तरह बड़े अक्षरों वाला URL, वही URL छोटे अक्षरों में हो तो उससे छोटा कोड बना सकता है।
- न्यूमेरिक: अंक 0–9, हर 3 अंक के लिए 10 बिट
- अल्फ़ान्यूमेरिक: 45 अक्षर, हर 2 अक्षर के लिए 11 बिट
- बाइट: कोई भी 8-बिट मान, हर बाइट के लिए 8 बिट
- कांजी: Shift JIS के दो-बाइट अक्षर, हर एक के लिए 13 बिट
मोड इंडिकेटर और सेगमेंट
डेटा का हर खंड 4-बिट के मोड इंडिकेटर और अक्षरों की गिनती से शुरू होता है, जिसकी लंबाई मोड और वर्शन पर निर्भर करती है। एक कोड में ऐसे कई सेगमेंट हो सकते हैं, जैसे अंकों की लंबी कतार के लिए न्यूमेरिक और बाकी के लिए बाइट, जिससे नतीजा छोटा बन सकता है।
दूसरे 4-बिट इंडिकेटर अक्षर सेट की जगह सुविधाओं का संकेत देते हैं: कैरेक्टर एन्कोडिंग बताने के लिए ECI, डेटा को कई कोड में बाँटने के लिए स्ट्रक्चर्ड अपेंड, और GS1 तथा दूसरे उद्योग डेटा फ़ॉर्मैट के लिए FNC1। चार शून्य बिट का टर्मिनेटर डेटा खत्म करता है।
- न्यूमेरिक 0001, अल्फ़ान्यूमेरिक 0010, बाइट 0100, कांजी 1000
- ECI 0111, स्ट्रक्चर्ड अपेंड 0011
- FNC1 पहली स्थिति 0101, दूसरी स्थिति 1001
- टर्मिनेटर 0000
बाइट मोड और कैरेक्टर सेट
मानक में बाइट मोड की डिफ़ॉल्ट व्याख्या ISO-8859-1 (Latin-1) है, पर आज ज़्यादातर जेनरेटर UTF-8 लिखते हैं ताकि मात्राओं वाले अक्षर, दूसरी लिपियाँ और इमोजी सही बने रहें। रीडर आम तौर पर बाइट जाँचकर UTF-8 पहचान लेते हैं।
जहाँ कैरेक्टर सेट में कोई अस्पष्टता नहीं होनी चाहिए, वहाँ ECI हेडर उसे साफ़ तौर पर बता सकता है। उसके बिना रीडर कभी-कभार गलत अंदाज़ा लगाकर बिगड़े अक्षर दिखा सकता है।